AI agent e developer: il futuro non è fuori dal loop, ma sopra il loop
Come cambia il lavoro del developer con gli AI agent: dal codice ai test, all’architettura e ai sistemi di controllo per mantenere qualità e comprensione.
In DeveloperWay ci troviamo sempre più spesso davanti allo stesso scenario: l’AI sta rendendo molto più semplice produrre software, ma non sta rendendo più semplice gestirne la complessità.
Scrivere una funzione richiede meno tempo. Creare un prototipo è diventato incredibilmente veloce. Anche modificare parti consistenti di un progetto può ormai richiedere pochi prompt.
Poi, però, quel software deve funzionare davvero.
Deve essere mantenibile, sicuro, integrarsi con ciò che esiste già, reggere nuove funzionalità e continuare a funzionare quando il progetto cresce.
Ed è proprio qui che la questione diventa interessante.
Per noi il punto non è tanto chiedersi se l’intelligenza artificiale sostituirà i developer. È una domanda enorme e, forse, persino poco utile.
Ce n’è una molto più concreta:
come cambia il lavoro del developer quando una parte sempre più grande del codice può essere prodotta da un agente?
È un tema particolarmente vicino a DeveloperWay, perché lavoriamo proprio nel punto in cui velocità e qualità tecnica devono incontrarsi: architettura, testing, integrazione, sicurezza, manutenzione e capacità di far evolvere un prodotto senza perderne il controllo.
L’AI può velocizzare enormemente l’implementazione.
Ma se possiamo produrre più codice e farlo più velocemente, diventa ancora più importante capire come verificare che quel codice sia corretto.
Ed è qui che il ruolo del developer comincia a cambiare.
Dal pair programming agli AI agent
Fino a poco tempo fa il rapporto tra developer e AI era abbastanza semplice.
Scrivevi una richiesta, l’assistente suggeriva del codice e tu decidevi se utilizzarlo.
In pratica, una versione molto evoluta dell’autocompletamento.
Con gli AI agent il meccanismo cambia.
Un agente non si limita necessariamente a rispondere a un prompt. Può ricevere un obiettivo, analizzare il progetto, pianificare una serie di passaggi, utilizzare strumenti, modificare file, eseguire test e correggere il proprio lavoro in base ai risultati ottenuti.
È per questo che nella letteratura sugli autonomous agent basati su LLM si parla di elementi come memoria, pianificazione, capacità di azione e interazione con l’ambiente.
Il modello linguistico è soltanto una parte del sistema.
La differenza si vede bene con un esempio.
Chiedere:
“Generami una funzione Laravel che salvi questo dato.”
non è la stessa cosa di chiedere:
“Analizza questa issue, individua i file coinvolti, implementa la funzionalità, aggiorna i test ed esegui la suite verificando che non siano state introdotte regressioni.”
Nel primo caso stiamo chiedendo del codice.
Nel secondo stiamo iniziando a delegare una parte del processo di sviluppo.
E più cresce la delega, più diventa importante capire quale debba essere il ruolo dell’essere umano.
Human outside the loop: quando guardiamo solo il risultato
Il primo scenario è quello più vicino al cosiddetto vibe coding.
Descriviamo ciò che vogliamo ottenere e lasciamo all’AI gran parte del lavoro.
A quel punto il controllo umano tende a concentrarsi soprattutto sul risultato:
la pagina si apre? Il pulsante funziona? Il form invia i dati? L’applicazione sembra fare ciò che avevamo chiesto?
Se la risposta è sì, si va avanti.
Kief Morris definisce questo approccio human outside the loop: l’essere umano controlla principalmente l’obiettivo, mentre l’agente gestisce gran parte dei passaggi necessari per raggiungerlo.
È un modello potentissimo, soprattutto quando bisogna costruire rapidamente un prototipo.
I problemi iniziano quando quel prototipo deve diventare un prodotto.
Una funzionalità può sembrare perfettamente funzionante e, nello stesso momento, introdurre duplicazioni, dipendenze inutili, vulnerabilità, regressioni, problemi di performance o semplicemente una struttura che tra sei mesi nessuno vorrà più toccare.
Perché il software non è solo quello che vediamo sullo schermo.
È anche tutto ciò che dovremo capire, modificare e mantenere in futuro.
Ed è proprio questo che rende rischiosa una delega senza controllo.
Human in the loop: controllare tutto non è necessariamente la soluzione
A questo punto la reazione naturale potrebbe essere quella opposta: controlliamo tutto.
L’agente scrive codice, il developer lo legge, lo corregge, approva ogni modifica e verifica ogni decisione.
È sicuramente un approccio più prudente.
Ma c’è un problema.
Se un agente riesce a produrre centinaia di modifiche in pochi minuti e noi dobbiamo leggere manualmente ogni singola riga, il collo di bottiglia non scompare: si sposta.
Prima era la scrittura del codice.
Ora diventa la review.
Il problema diventa ancora più evidente immaginando un futuro in cui più agenti lavorano contemporaneamente sullo stesso progetto o su parti differenti del sistema.
A quel punto pensare che un essere umano possa controllare manualmente ogni singola modifica rischia semplicemente di non scalare.
Ed è qui che arriviamo all’idea più interessante.
Human on the loop: non controllare tutto, ma controllare il sistema
Morris propone un terzo approccio: human on the loop.
Il developer non deve necessariamente osservare ogni azione compiuta dall’agente.
Deve però progettare il sistema dentro cui quell’agente lavora.
Questo significa definire obiettivi, vincoli architetturali, standard, test, strumenti, feedback automatici e criteri di accettazione.
L’agente può avere un certo livello di autonomia, ma all’interno di confini definiti.
La domanda cambia completamente.
Non è più:
“Ho controllato tutto il codice prodotto dall’AI?”
Diventa:
“Ho costruito un sistema capace di accorgersi quando il codice prodotto dall’AI non rispetta ciò che mi aspetto?”
La differenza sembra piccola, ma in realtà cambia completamente il modo di progettare il lavoro.
Il developer passa dal controllo di ogni singola azione al controllo del processo.
L’agent harness: il sistema dentro cui lavora l’AI
Morris usa il termine agent harness per descrivere proprio questo ambiente.
Possiamo immaginarlo come un insieme di guardrail che aiutano l’agente a lavorare nel modo corretto.
Dentro potrebbero esserci la documentazione del progetto, le convenzioni del repository, test unitari e di integrazione, linting, type checking, controlli di sicurezza, pipeline CI/CD, sandbox, monitoring e strumenti di analisi del codice.
Immaginiamo, per esempio, che l’agente debba aggiungere una nuova API.
In un processo completamente manuale il developer scriverebbe controller, validazione, logica, test e tutto ciò che serve.
In un workflow agentico potrebbe invece definire il comportamento desiderato e lasciare all’agente l’implementazione.
L’implementazione, però, non arriverebbe direttamente in produzione.
Attraverserebbe una serie di controlli:
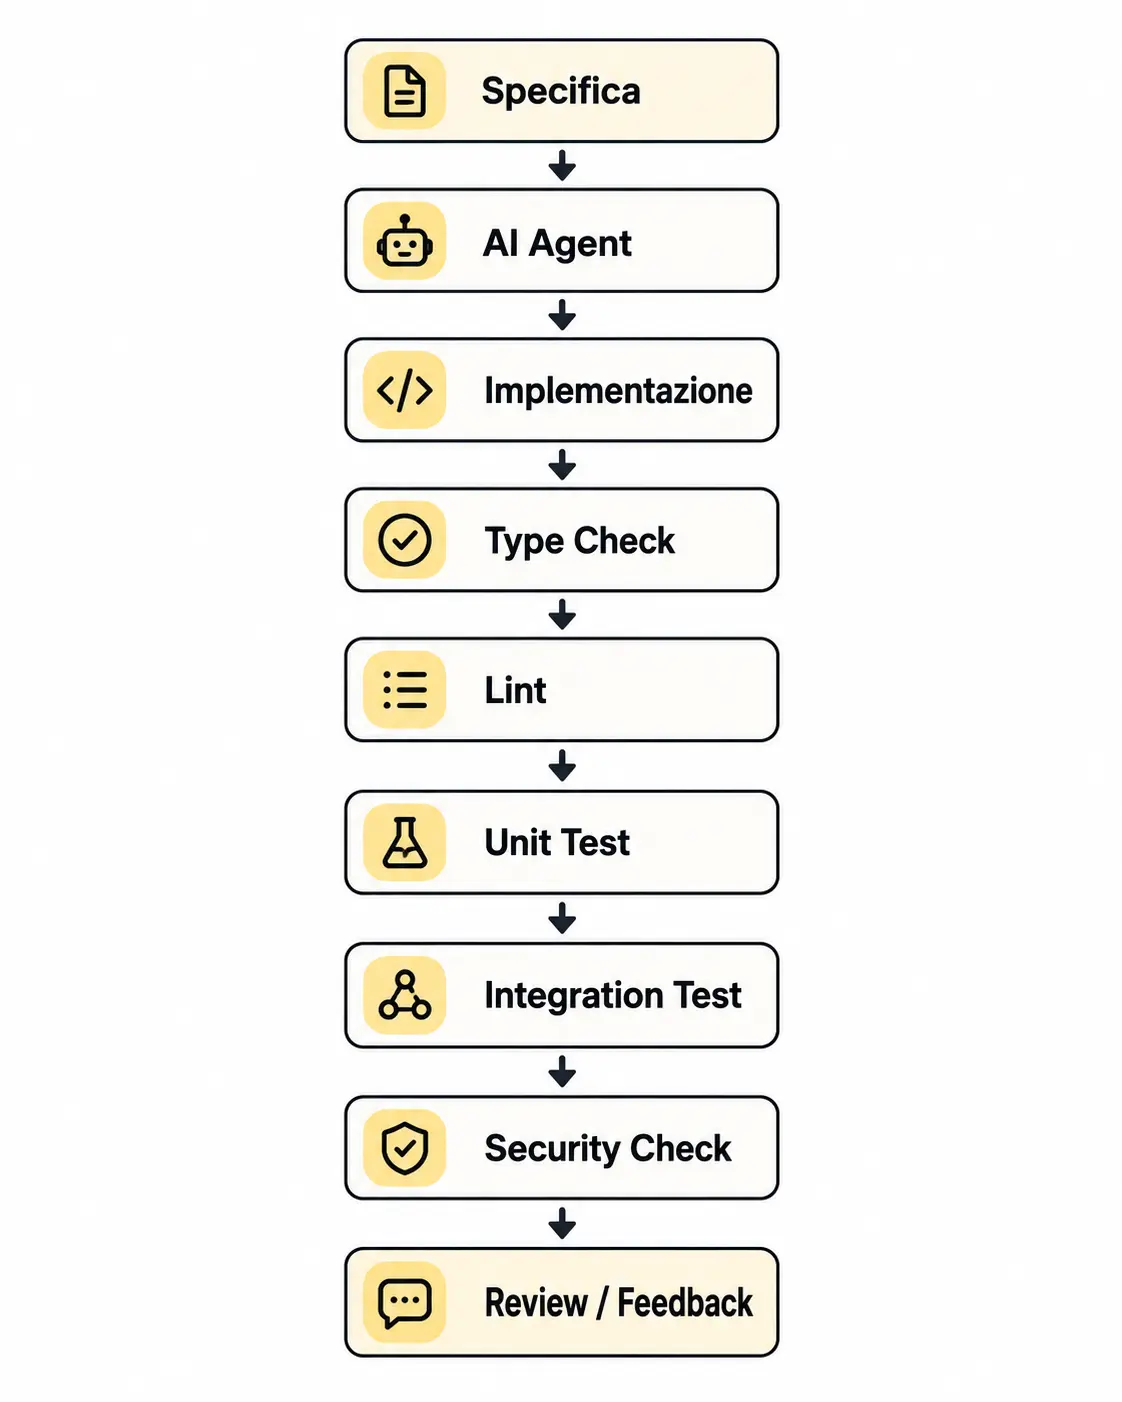
Se uno di questi passaggi fallisce, il codice torna indietro.
Il developer potrebbe non aver letto ogni singola riga generata.
Ha però deciso quali condizioni debbano essere rispettate perché quella modifica possa essere considerata accettabile.
Ed è qui che avviene il vero passaggio: dal controllo diretto al controllo sistemico.
Più codice produce l’AI, più diventano importanti i test
A prima vista può sembrare un paradosso.
Se l’intelligenza artificiale diventa sempre più brava a programmare, perché testing e competenze tecniche dovrebbero diventare ancora più importanti?
Perché scrivere codice e dimostrare che quel codice sia corretto sono due problemi diversi.
Se il costo della produzione scende, possiamo produrre molto più software.
E più codice produciamo, più abbiamo bisogno di sistemi in grado di verificarne automaticamente correttezza, integrazione, sicurezza, performance e coerenza con l’architettura esistente.
Il valore, quindi, tende a spostarsi.
Non basta più essere bravi a scrivere una funzione.
Diventa sempre più importante essere bravi a definire ciò che rende quella funzione corretta.
In altre parole:
più codice riesce a scrivere l’AI, più valore si sposta dalla scrittura del codice alla progettazione del sistema che decide se quel codice è corretto.
Fidarsi dell’AI è un problema di engineering
C’è poi una seconda questione, forse ancora più delicata: la fiducia.
Uno studio condotto da Google su 76 software engineer ha analizzato cosa succede quando gli sviluppatori utilizzano assistenti generativi durante attività di programmazione.
I risultati mostrano che l’effetto dell’AI non è uguale per tutti: cambia in base al tipo di attività e all’esperienza del developer.
Ma emerge anche un fenomeno particolarmente interessante, chiamato automation complacency.
In sostanza, quando utilizziamo per molto tempo un sistema che spesso produce risultati corretti, tendiamo naturalmente ad abbassare la guardia.
Iniziamo a controllarlo meno.
Ed è perfettamente comprensibile.
Se nove suggerimenti consecutivi funzionano, al decimo probabilmente saremo meno propensi a verificarlo con la stessa attenzione del primo.
Il problema è che “quasi sempre corretto” non significa “sempre corretto”.
Per questo un buon workflow agentico non dovrebbe basarsi soltanto sulla disciplina personale del developer.
Non dovremmo limitarci a dire:
“Ricordati di controllare ciò che genera l’AI.”
Dovremmo costruire un processo in cui una parte importante di quel controllo avvenga automaticamente.
Sentirsi più veloci non significa necessariamente esserlo
Anche il rapporto tra AI e produttività è meno lineare di quanto potrebbe sembrare.
Uno degli studi più citati su GitHub Copilot ha mostrato che, durante un esperimento controllato, gli sviluppatori che utilizzavano Copilot completavano uno specifico task JavaScript circa il 55,8% più velocemente rispetto al gruppo di controllo.
Un risultato notevole.
Ma non significa che l’AI renda automaticamente qualsiasi developer più veloce in qualsiasi contesto.
Un esperimento condotto da METR nel 2025 ha infatti osservato un risultato molto diverso.
Lo studio ha coinvolto 16 developer open source esperti impegnati su 246 attività reali all’interno di repository che conoscevano molto bene.
Con gli strumenti AI disponibili all’inizio del 2025, i partecipanti hanno impiegato mediamente il 19% di tempo in più.
Il dato forse più curioso riguarda però la percezione.
Prima dell’esperimento, i developer pensavano che l’AI li avrebbe resi circa il 24% più veloci.
Dopo aver lavorato con questi strumenti continuavano a credere di aver risparmiato circa il 20% del tempo.
Le misurazioni raccontavano il contrario.
Naturalmente il risultato non va generalizzato: lo stesso METR sottolinea che si trattava di developer esperti, repository maturi e strumenti appartenenti a una specifica fase dell’evoluzione tecnologica.
Nel febbraio 2026 l’organizzazione ha inoltre segnalato che dati più recenti sembrano indicare un miglioramento delle performance degli strumenti AI.
La lezione, però, rimane interessante:
la sensazione di essere più produttivi non è necessariamente una buona misura della produttività reale.
Un buon agente non è semplicemente quello che scrive codice corretto
Per molto tempo abbiamo valutato i sistemi AI soprattutto attraverso benchmark.
Gli assegniamo un problema, generano una soluzione e verifichiamo se quella soluzione sia corretta.
Nel software reale, però, le cose sono decisamente più confuse.
Una richiesta può essere incompleta.
Il codebase può avere anni di storia.
Esistono convenzioni non documentate, trade-off, dipendenze, comportamenti legacy e decisioni architetturali che non sono evidenti guardando soltanto una singola issue.
Un agente deve quindi fare molto più che produrre codice sintatticamente corretto.
Deve capire il contesto.
Deve rispettare le convenzioni.
Deve sapere quando fermarsi.
Deve evitare modifiche inutili.
E, soprattutto, deve riuscire a collaborare con il developer.
Una ricerca presentata a ICML 2026 ha evidenziato proprio questo limite dei benchmark tradizionali.
Molti test misurano quanto bene un agente riesca a completare autonomamente un task. Nell’utilizzo reale, invece, il lavoro è spesso molto più collaborativo.
Lo studio, condotto attraverso una piattaforma basata su OpenHands e dati provenienti da circa 15.000 utenti, ha trovato differenze importanti tra performance misurate nei benchmark e soddisfazione degli utenti.
E questo suggerisce una domanda diversa.
Non soltanto:
“Quanto è bravo l’agente?”
Ma:
“Quanto funziona bene il sistema composto da developer e agente?”
Dalla correctness alla collaboration
Anche un recente lavoro di Google segue questa direzione.
Analizzando le regole che i developer definiscono per gli agenti software e intervistando professionisti esperti, i ricercatori hanno individuato quattro grandi aspettative.
Un buon coding agent dovrebbe rispettare standard e processi, garantire qualità e affidabilità, risolvere efficacemente i problemi e collaborare correttamente con il developer.
Quest’ultimo punto è particolarmente interessante.
Perché significa che arrivare alla risposta giusta non basta.
Conta anche come ci si arriva.
Un agente potrebbe implementare una funzionalità perfettamente funzionante e, allo stesso tempo, introdurre una dipendenza inutile, ignorare l’architettura del progetto o modificare componenti che non aveva motivo di toccare.
Dal punto di vista puramente funzionale avrebbe “risolto il task”.
Dal punto di vista del team, potrebbe aver creato un problema.
Il developer diventerà un orchestratore?
È facile, arrivati a questo punto, saltare alla conclusione che i developer del futuro non scriveranno più codice.
Probabilmente è troppo semplice.
È più realistico immaginare uno spostamento progressivo del lavoro.
Scrivere codice continuerà a essere importante, ma aumenterà il peso di altre capacità: definire bene un problema, progettare l’architettura, scomporre attività complesse, costruire test, valutare trade-off, diagnosticare errori e progettare pipeline di verifica.
In sostanza, diventa sempre più importante capire cosa deve essere costruito, perché e come verificare che funzioni davvero.
Il codice resta.
Ma potrebbe smettere di essere il centro assoluto del lavoro.
E per i junior developer?
Qui il discorso diventa ancora più interessante.
Tradizionalmente, una parte importante dell’apprendimento di un developer avveniva attraverso attività relativamente semplici: bug piccoli, CRUD, endpoint, componenti UI, refactoring circoscritti.
Sono esattamente molte delle attività che oggi possiamo delegare più facilmente all’AI.
Ed emerge un paradosso.
Un junior può produrre software molto più velocemente rispetto a pochi anni fa, ma potrebbe avere meno occasioni per costruire quella conoscenza necessaria a capire se ciò che è stato prodotto sia realmente corretto.
In altre parole, l’AI rende possibile produrre oltre il proprio livello di comprensione.
Non è necessariamente un male.
Può anzi essere un acceleratore straordinario dell’apprendimento.
Ma solo se produzione e comprensione non vengono confuse.
Usare un agente per implementare qualcosa può essere utilissimo se continuiamo a chiederci perché sia stata scelta una determinata architettura, quali alternative esistano, cosa possa rompersi, quali test siano necessari e quali problemi di sicurezza potrebbero emergere.
La competenza fondamentale potrebbe quindi non essere più soltanto:
“So scriverlo senza AI?”
ma anche:
“Sono in grado di capire se quello che l’AI ha prodotto ha senso?”
Il vero futuro potrebbe essere il feedback loop
La ricerca sugli agenti autonomi descrive sempre più spesso sistemi basati su cicli continui di pianificazione, azione, osservazione e feedback.
Nel software engineering potremmo quindi vedere processi sempre più simili a questo:
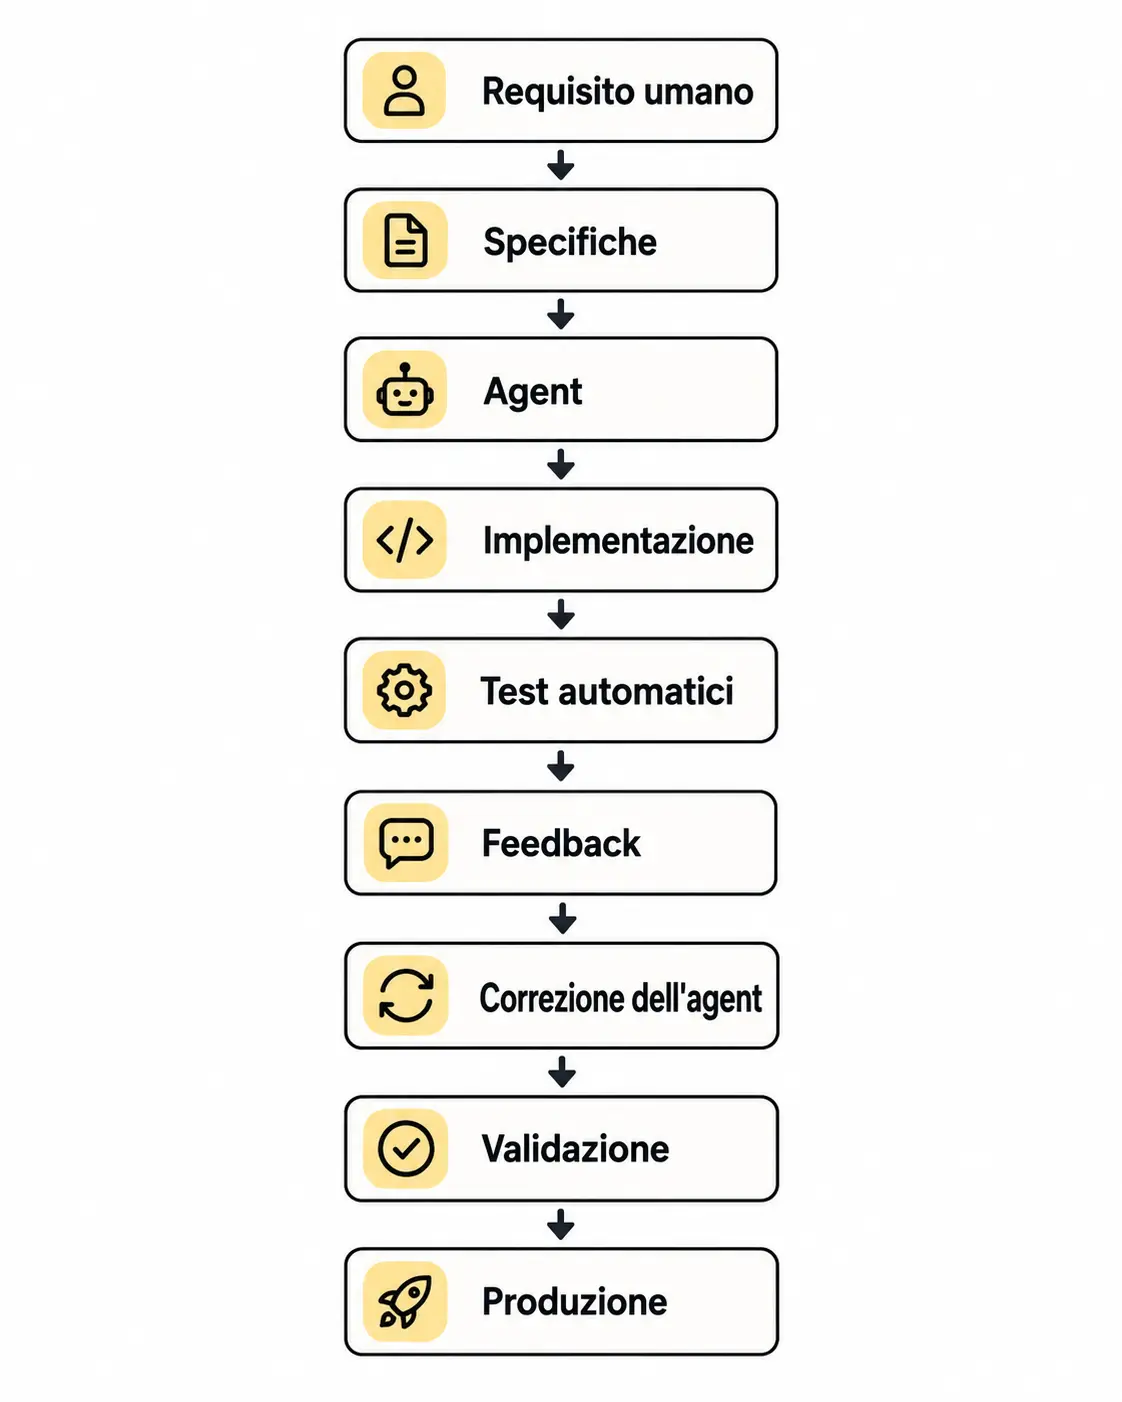
La parte interessante è ciò che succede al ruolo del developer.
Il codice non è più necessariamente il principale punto di interazione con il sistema.
Lo diventano le specifiche, i test, i vincoli e il feedback.
Il developer non sparisce.
Semplicemente lavora a un livello diverso.
Meno codice non significa meno engineering
Quando arriva una tecnologia capace di automatizzare una parte del nostro lavoro, siamo portati a pensare che quella competenza diventerà meno importante.
Nel software potrebbe accadere qualcosa di diverso.
Se produrre codice diventa molto economico, produrremo inevitabilmente più codice.
Ma quel codice dovrà comunque essere scelto, verificato, integrato, mantenuto e monitorato.
L’intelligenza artificiale può ridurre drasticamente il costo della produzione.
Non elimina il costo della complessità.
Ed è forse questa la parte più interessante del cambiamento che stiamo osservando anche in DeveloperWay.
Il futuro dello sviluppo software potrebbe non essere semplicemente fatto di developer che scrivono meno codice.
Potrebbe essere fatto di developer che dedicano una parte crescente del proprio tempo a progettare sistemi capaci di produrre, verificare e correggere codice.
La domanda, allora, smette di essere:
“L’AI saprà programmare meglio degli sviluppatori?”
E diventa molto più concreta:
“Come possiamo progettare un sistema in cui developer e agenti AI lavorino insieme senza perdere controllo, qualità e comprensione?”
Forse è proprio questa l’evoluzione più interessante del ruolo del developer.
Non fuori dal loop.
Non necessariamente dentro ogni singola azione.
Ma sopra il loop, a progettare il modo in cui quel loop funziona.
Riferimenti
- Morris, K. (2026). Humans and Agents in Software Engineering Loops. MartinFowler.com.
- Qian, C., Wexler, J. et al. (2024). Take it, Leave it, or Fix it: Measuring Productivity and Trust in Human-AI Collaboration. IUI 2024.
- Wang, L., Ma, C., Feng, X. et al. (2024). A survey on large language model based autonomous agents. Frontiers of Computer Science, 18.
- Peng, S., Kalliamvakou, E., Cihon, P. & Demirer, M. (2023). The Impact of AI on Developer Productivity: Evidence from GitHub Copilot.
- Becker, J., Rush, N., Barnes, B. & Rein, D. (2025). Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity. METR.
- Chen, V., Malhotra, R., Wang, X. et al. (2026). How can we assess human-agent interactions? Case studies in software agent design. ICML 2026.
- Dong, T., Shi, S., Sampath, H. & Macvean, A. (2026). Towards AI as a Collaborative Partner: A Taxonomy of AI Agent Behavior in Software Engineering. ACM AIware '26.
- Huang, X., Liu, W., Chen, X. et al. (2024). Understanding the Planning of LLM Agents: A Survey.